Análisis NLP de ~30.000 letras de canciones argentinas extraídas de La Cuerda, enriquecidas con metadatos de la API de Spotify. Aplicamos LDA topic modeling para descubrir cinco temas latentes en el corpus, y entrenamos clasificadores de estilo musical comparando TF-IDF, Word2Vec y BERT. El hallazgo más interesante: un modelo Word2Vec entrenado sobre el corpus propio supera al preentrenado en Wikipedia, capturando mejor el vocabulario coloquial y poético de las letras argentinas.
¿Alcanza con leer la letra de una canción para adivinar su estilo musical? Esa es la pregunta que dispara este proyecto. Para responderla, aplicamos técnicas de Procesamiento de Lenguaje Natural (NLP) a un corpus de canciones argentinas, buscando patrones de vocabulario y temática lo bastante fuertes como para predecir el género.
El enfoque general se llama lectura distante: en vez de leer canción por canción, se analiza el corpus completo con estadística y aprendizaje automático para revelar patrones que serían imposibles de notar a simple vista. Para este proyecto reunimos cerca de 30.000 letras de canciones argentinas del sitio La Cuerda y las enriquecimos con metadatos de la API de Spotify (popularidad, duración, artista).
Metodología
Recolección y Preparación de Datos
Con las letras y los metadatos ya reunidos, el siguiente paso fue preparar el texto para el análisis. El preprocesamiento incluyó:
- Limpieza de texto (eliminación de caracteres especiales y normalización)
- Lematización con spaCy para reducir palabras a su forma base
- Cálculo de métricas como TTR (Type-Token Ratio) para medir riqueza léxica
Análisis Exploratorio y Modelado de Tópicos
Para explorar el corpus sin depender de las etiquetas de estilo, aplicamos LDA (Latent Dirichlet Allocation): un algoritmo de topic modeling que agrupa palabras que suelen aparecer juntas y así revela los grandes temas -- o tópicos -- presentes en el texto, sin que nadie los haya etiquetado a mano. El algoritmo encontró cinco tópicos principales: religioso, existencial, naturista, desamor y folklórico. Cada canción quedó etiquetada con el tópico al que pertenece con mayor probabilidad.
Feature Engineering
Además de la vectorización del texto, diseñamos features adicionales:
- Proporción de stopwords: indicador de complejidad léxica
- Proporción de palabras en inglés: relevante para ciertos géneros como pop o rock
- Longitud media de palabra: asociada a estilos más tradicionales
- Repeticiones: frecuencia de palabras repetidas
- Polaridad de sentimiento: calculada con TextBlob
Vectorización del Texto
Antes de que un algoritmo de machine learning pueda usar el texto, este tiene que convertirse en números -- proceso conocido como vectorización. Probamos tres técnicas, de la más simple a la más sofisticada:
- TF-IDF: pondera frecuencia de términos penalizando palabras muy comunes
- Word2Vec: embeddings que capturan relaciones semánticas (modelo propio y preentrenado)
- BERT: embeddings contextuales usando un modelo preentrenado en español
Clasificación
Con el texto ya vectorizado, entrenamos dos clasificadores clásicos para predecir el estilo musical: Regresión Logística (multinomial) y Support Vector Machines (SVM, variante LinearSVC). Comparamos cada combinación de vectorización + clasificador usando F1-score macro, una métrica que promedia el desempeño por clase para que el estilo mayoritario (rock) no opaque a los demás.
Problemas y Soluciones
- Desbalance de clases: el dataset tiene una fuerte predominancia del rock sobre otros estilos. Usamos el parámetro
class_weight='balanced'en los clasificadores y priorizamos métricas como F1-macro por sobre el accuracy plano. - Ambigüedad en la definición de 'estilo': las etiquetas de estilo en La Cuerda mezclan criterios instrumentales, temáticos y de formación del grupo. Complementamos el análisis con clustering no supervisado para descubrir agrupaciones naturales, independientes de esas etiquetas.
- Limitaciones de Word2Vec preentrenado: el modelo preentrenado en Wikipedia española rindió peor que uno entrenado desde cero sobre nuestro propio corpus de canciones, que captura mejor el vocabulario coloquial y poético de las letras argentinas.
Resultados
Desempeño de los Modelos
| Técnica | Clasificador | F1-Macro |
|---|---|---|
| TF-IDF | Regresión Logística | 0.37 |
| TF-IDF | SVM | 0.34 |
| Word2Vec (propio) | SVM | 0.33 |
| BERT | SVM | 0.35 |
| Feature Engineering | SVM | 0.18 |
El modelo más simple -- TF-IDF combinado con Regresión Logística -- fue el que mejor resultado dio. Técnicas más sofisticadas como BERT no mejoraron el desempeño de forma significativa, lo que sugiere que el cuello de botella no está en cómo se representa el texto, sino en la calidad de las etiquetas y el desbalance de clases.
Precisión por Estilo
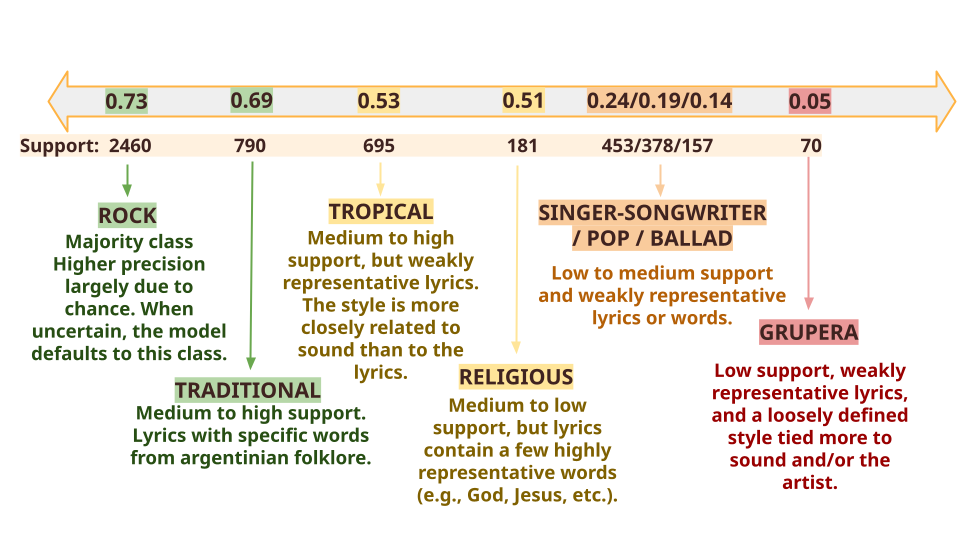
Precisión del mejor modelo (TF-IDF + Regresión Logística) para cada estilo musical. Se observa una clara influencia del número de muestras y la naturaleza del estilo en la capacidad predictiva.
Hallazgos del Análisis de Coeficientes
Los coeficientes de la regresión logística funcionan como un ranking: muestran qué palabras empujan la predicción hacia cada estilo. Estas fueron las más reveladoras:
- Rock: punk, mierda, aguante (vocabulario directo y agresivo)
- Religioso: jesús, espíritu, dios (léxico espiritual explícito)
- Tropical: cumbia, cuerpo, cariño (referencias al baile y romance)
- Tradicional: cantor, monte, andar (imaginario folklórico)
Conclusiones
- Existe una relación entre texto y estilo, pero es parcial. Las letras aportan información valiosa, especialmente para géneros definidos temáticamente (religioso, folklórico).
- El desbalance y la ambigüedad de etiquetas son los principales limitantes, más que la técnica de vectorización elegida.
- El artista es un predictor fuerte: al incluir información del artista, el desempeño mejora significativamente.
- La lectura distante complementa, no reemplaza, el análisis tradicional. Permite identificar patrones a escala, pero requiere interpretación humana para validar los hallazgos.
Este proyecto demuestra el potencial del NLP para analizar corpus culturales masivos, revelando la compleja relación entre palabras, música e identidad en la canción popular argentina.
Tecnologías
Agradecimientos
Este trabajo fue producto de la mentoría dictada por Facundo Calabró en el contexto de la Diplomatura en Ciencia de Datos, Aprendizaje Automático y sus Aplicaciones (FAMAF) y fue realizado en conjunto con Lautaro Puican e Iván Kwist.