¿Qué estrategia de optimización conviene más para controlar un sistema cuántico mediante pulsos magnéticos: Deep Reinforcement Learning o algoritmos genéticos? Este trabajo, publicado en Physica Scripta, compara ambos enfoques para la transmisión de estados cuánticos en cadenas de qubits, midiendo fidelidad y costo computacional en el régimen de control ideal (sin ruido). El resultado es contundente: el algoritmo genético (GA) gana con claridad, alcanzando fidelidades más altas y corriendo entre 2 y 3 órdenes de magnitud más rápido que un DQN. ¿Y si el control no es perfecto? Esa pregunta se aborda en el trabajo complementario sobre robustez frente a ruido dinámico.
En términos simples, la transferencia de estado cuántico (QST) consiste en mover información cuántica de un extremo a otro de una cadena de qubits sin perderla en el camino, algo necesario para conectar distintas partes de un futuro procesador cuántico. Por eso la QST a través de cadenas de espín homogéneas desempeña un papel crucial en la construcción de hardware cuántico escalable. Un protocolo básico de transmisión de estados cuánticos prepara un estado en un qubit y lo transfiere a otro a través de un canal, buscando minimizar el tiempo y evitar pérdida de información. La fidelidad del proceso —qué tan parecido es el estado recibido al que se quería enviar— se mide mediante funciones proporcionales a la probabilidad de transición entre ambos estados.
Tomando como punto de partida el trabajo de Zhang et al. [1], que propone el uso de deep reinforcement learning para controlar la transferencia de estados cuánticos, abordamos este problema de optimización mediante pulsos magnéticos constantes y dos estrategias complementarias: aprendizaje por refuerzo profundo (DRL), donde un agente aprende secuencias de pulsos mediante recompensas, y algoritmos genéticos (GA), que desarrollan soluciones candidatas mediante selección y mutación. Analizamos la eficiencia de ambos métodos, su capacidad para incorporar restricciones físicas y, sobre todo, cómo se comportan cuando el control deja de ser perfecto.
Control Dinámico
En términos concretos, controlar el sistema significa aplicar sobre la cadena una secuencia de pulsos magnéticos, uno después del otro, eligiendo su forma para guiar el estado cuántico de un extremo al otro. El sistema consiste en una cadena de N qubits con Hamiltoniano de intercambio XX que evoluciona bajo Hamiltonianos independientes del tiempo por intervalos. El control se implementa mediante pulsos de campo magnético aplicados en subintervalos de tiempo discretos:
- En cada subintervalo se aplica una configuración Bk,j de campos elegida de un conjunto de configuraciones posibles
- Se busca encontrar una secuencia óptima de 5N compuertas de un qubit que transmitan el estado desde el primer al último qubit
- Las configuraciones posibles de campos definen el espacio de acciones
En este trabajo exploramos dos espacios de acciones diferentes:
- Espacio de acciones original de Zhang et al.: Un conjunto de 16 acciones que aplican campos magnéticos predefinidos sobre sitios específicos de la cadena, tal como fue propuesto en el trabajo original.
- Una acción por sitio: Un espacio de acciones simplificado donde cada acción consiste en encender un campo magnético sobre un único sitio de la cadena (N acciones posibles), permitiendo mayor granularidad en el control.
Estrategias de Control
Algoritmos Genéticos (GA)
El algoritmo genético se implementó usando PyGAD con evaluación paralela de poblaciones mediante PyTorch:
- La población inicial consiste en secuencias aleatorias de 5N acciones
- Se simula la aplicación de cada secuencia y se les asigna una fitness proporcional a la calidad de transmisión, evaluada sobre toda la evolución temporal
- Se seleccionan las secuencias de mayor fidelidad como padres (selección steady-state) y se genera una nueva población mediante cruzamiento uniforme y mutación por intercambio (swap)
- La estructura y simpleza del algoritmo genético permiten que sea fácil de paralelizar en GPU
| Hiperparámetro del GA | Valor |
|---|---|
| Máximo de generaciones | 1000 |
| Tamaño de la población | 4096 |
| Saturación (generaciones sin mejora) | 30 |
| Tipo de mutación | swap |
| Probabilidad de mutación | 0.99 |
| Genes mutados | N |
| Tipo de selección de padres | 'sss' (steady-state) |
| Padres apareados / elitismo | 409 / 409 |
| Tipo y probabilidad de cruzamiento | uniforme, 0.8 |
Tabla I. Hiperparámetros del algoritmo genético utilizados para obtener los resultados presentados en el paper.
Un barrido sistemático de los parámetros físicos del control —el campo magnético h y el paso temporal Δt— sobre una cadena de N=64 qubits mostró que el GA encuentra secuencias con probabilidad de transmisión P(t)>0.99 en una región amplia de ese espacio de parámetros, sin necesidad de un ajuste fino.
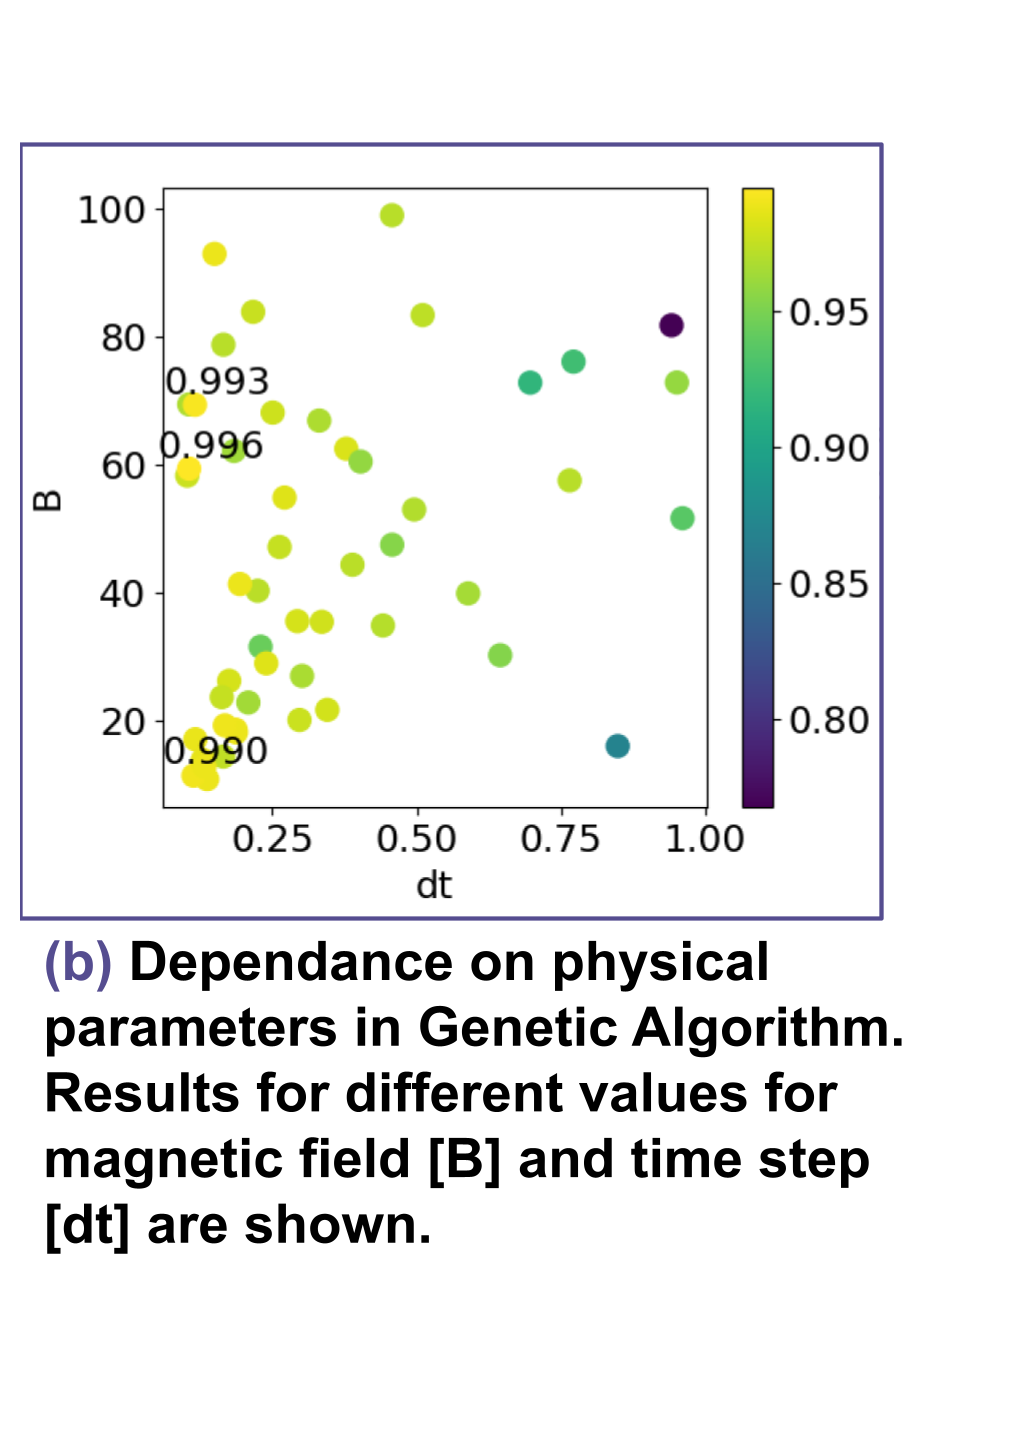
Probabilidad de transmisión del GA según los parámetros físicos del control (h, Δt), para N=64.
Deep Reinforcement Learning (DRL)
El agente DRL se implementó como una Deep Q-Network (DQN) con replay de experiencia priorizado usando TensorFlow, adaptado de la implementación de Zhang et al.:
- El espacio de estados codifica la parte real e imaginaria de cada coeficiente del vector de estado de la cadena, s(t) = (Re{ψ₁},...,Re{ψN},Im{ψ₁},...,Im{ψN})
- Se entrena el agente con una política ε-greedy: explora acciones al azar con probabilidad ε y explota la mejor acción conocida el resto del tiempo, minimizando el error cuadrático entre la red Q y una red objetivo periódicamente actualizada
- La recompensa es una función escalonada de la probabilidad de transmisión: crece suavemente para P(t)≤0.8, se acelera hasta P(t)=1-χ, y salta a un valor muy alto (2500) apenas se supera ese umbral, empujando al agente a buscar transmisiones casi perfectas
- Inyección de ruido durante el entrenamiento episódico (domain randomization, es decir, variar aleatoriamente las condiciones de entrenamiento para que el agente generalice mejor) para mejorar la robustez frente a control imperfecto
- El desempeño de DRL depende fuertemente de la elección de hiperparámetros y condiciones de entrenamiento
| Hiperparámetro del DQN (línea base, Zhang et al.) | Valor |
|---|---|
| Tamaño de minibatch | 32 |
| Tasa de aprendizaje | 0.01 |
| Factor de descuento (γ) | 0.95 |
| Tamaño de la memoria de replay | 40000 |
| Neuronas (1ª / 2ª capa oculta) | 120 / 40 |
| Tasa ε-greedy | 1 → 0.01 (decay 0.0001) |
| Número de episodios | 50000 |
| Período de aprendizaje (t') | 5 timesteps |
| Período de reemplazo de la red objetivo (C) | 200 episodios |
Tabla III. Hiperparámetros de la implementación original del DQN, adaptada de Zhang et al. [1], usada como línea base de comparación.
Resultados sin Ruido: GA vs DRL
GA: acciones por sitio vs acciones de Zhang
(a) Probabilidad de transmisión máxima obtenida por el GA en función de la longitud de la cadena, usando el conjunto de acciones por sitio (rojo) y el conjunto propuesto por Zhang et al. (azul). Los cuadrados son el mejor valor sobre 30 poblaciones iniciales, los círculos el promedio de esos máximos. (b) Evolución temporal de P(t) para N=32 con ambos conjuntos de acciones, comparada con la evolución natural sin control (verde).
DQN original: fidelidad vs longitud de cadena
(a) Probabilidad de transmisión máxima obtenida por el DQN (hiperparámetros originales de Zhang et al.) en función de la longitud de cadena, sobre 30 realizaciones de los pesos iniciales de la red. (b) Evolución temporal de P(t) para N=32 en cada realización (negro), comparada con la evolución natural (verde).
- Con el conjunto de acciones por sitio, el GA mantiene P(t)≳0.99 para todas las longitudes de cadena estudiadas; con el conjunto de Zhang et al., su desempeño decae con N
- El DQN original iguala al GA solo para cadenas muy cortas (N≈8-12); a partir de ahí la brecha se agranda claramente a medida que crece la longitud de la cadena
- Ambos métodos encuentran secuencias que llevan la transmisión a su máximo en tiempos cercanos al límite cuántico de velocidad (QSL) —el tiempo mínimo teórico que la dinámica permite para completar la transferencia—, pero solo el GA lo hace de forma consistente en calidad
Comparación de Desempeño y Costo Computacional
Ambos métodos se evaluaron en términos de fidelidad máxima, desempeño promedio y costo computacional.
Fidelidad: GA vs DRL
Comparación directa entre el GA con acciones por sitio (rojo) y el DQN original (negro): probabilidad de transmisión máxima vs longitud de cadena (a) y evolución temporal de P(t) para N=32 (b).
Tiempos de CPU

Tiempos de ejecución requeridos por GA (rojo) y DQN (negro) para alcanzar sus criterios de convergencia, en escala logarítmica.
Observaciones clave:
- El algoritmo genético permite obtener secuencias que alcanzan fidelidades más altas que el DQN original, salvo para cadenas muy cortas donde ambos son comparables
- Para cadenas de más qubits es conveniente cambiar el conjunto de acciones y usar el esquema por sitio
- El algoritmo DQN emplea tiempos de ejecución entre 2 y 3 órdenes de magnitud mayores que los requeridos por el GA; esa diferencia de costo es la que permitió automatizar la búsqueda de hiperparámetros y probar múltiples funciones de fitness y conjuntos de acciones para el GA, algo inviable de replicar de la misma forma con el DQN
Distribución de Acciones en las Secuencias del GA
Para entender qué hace el GA en la práctica, se analizó, sobre 1000 secuencias exitosas (P(t)≳0.99) con el esquema por sitio, qué tan seguido se actúa sobre cada sitio de la cadena, para distintas longitudes:
N=8
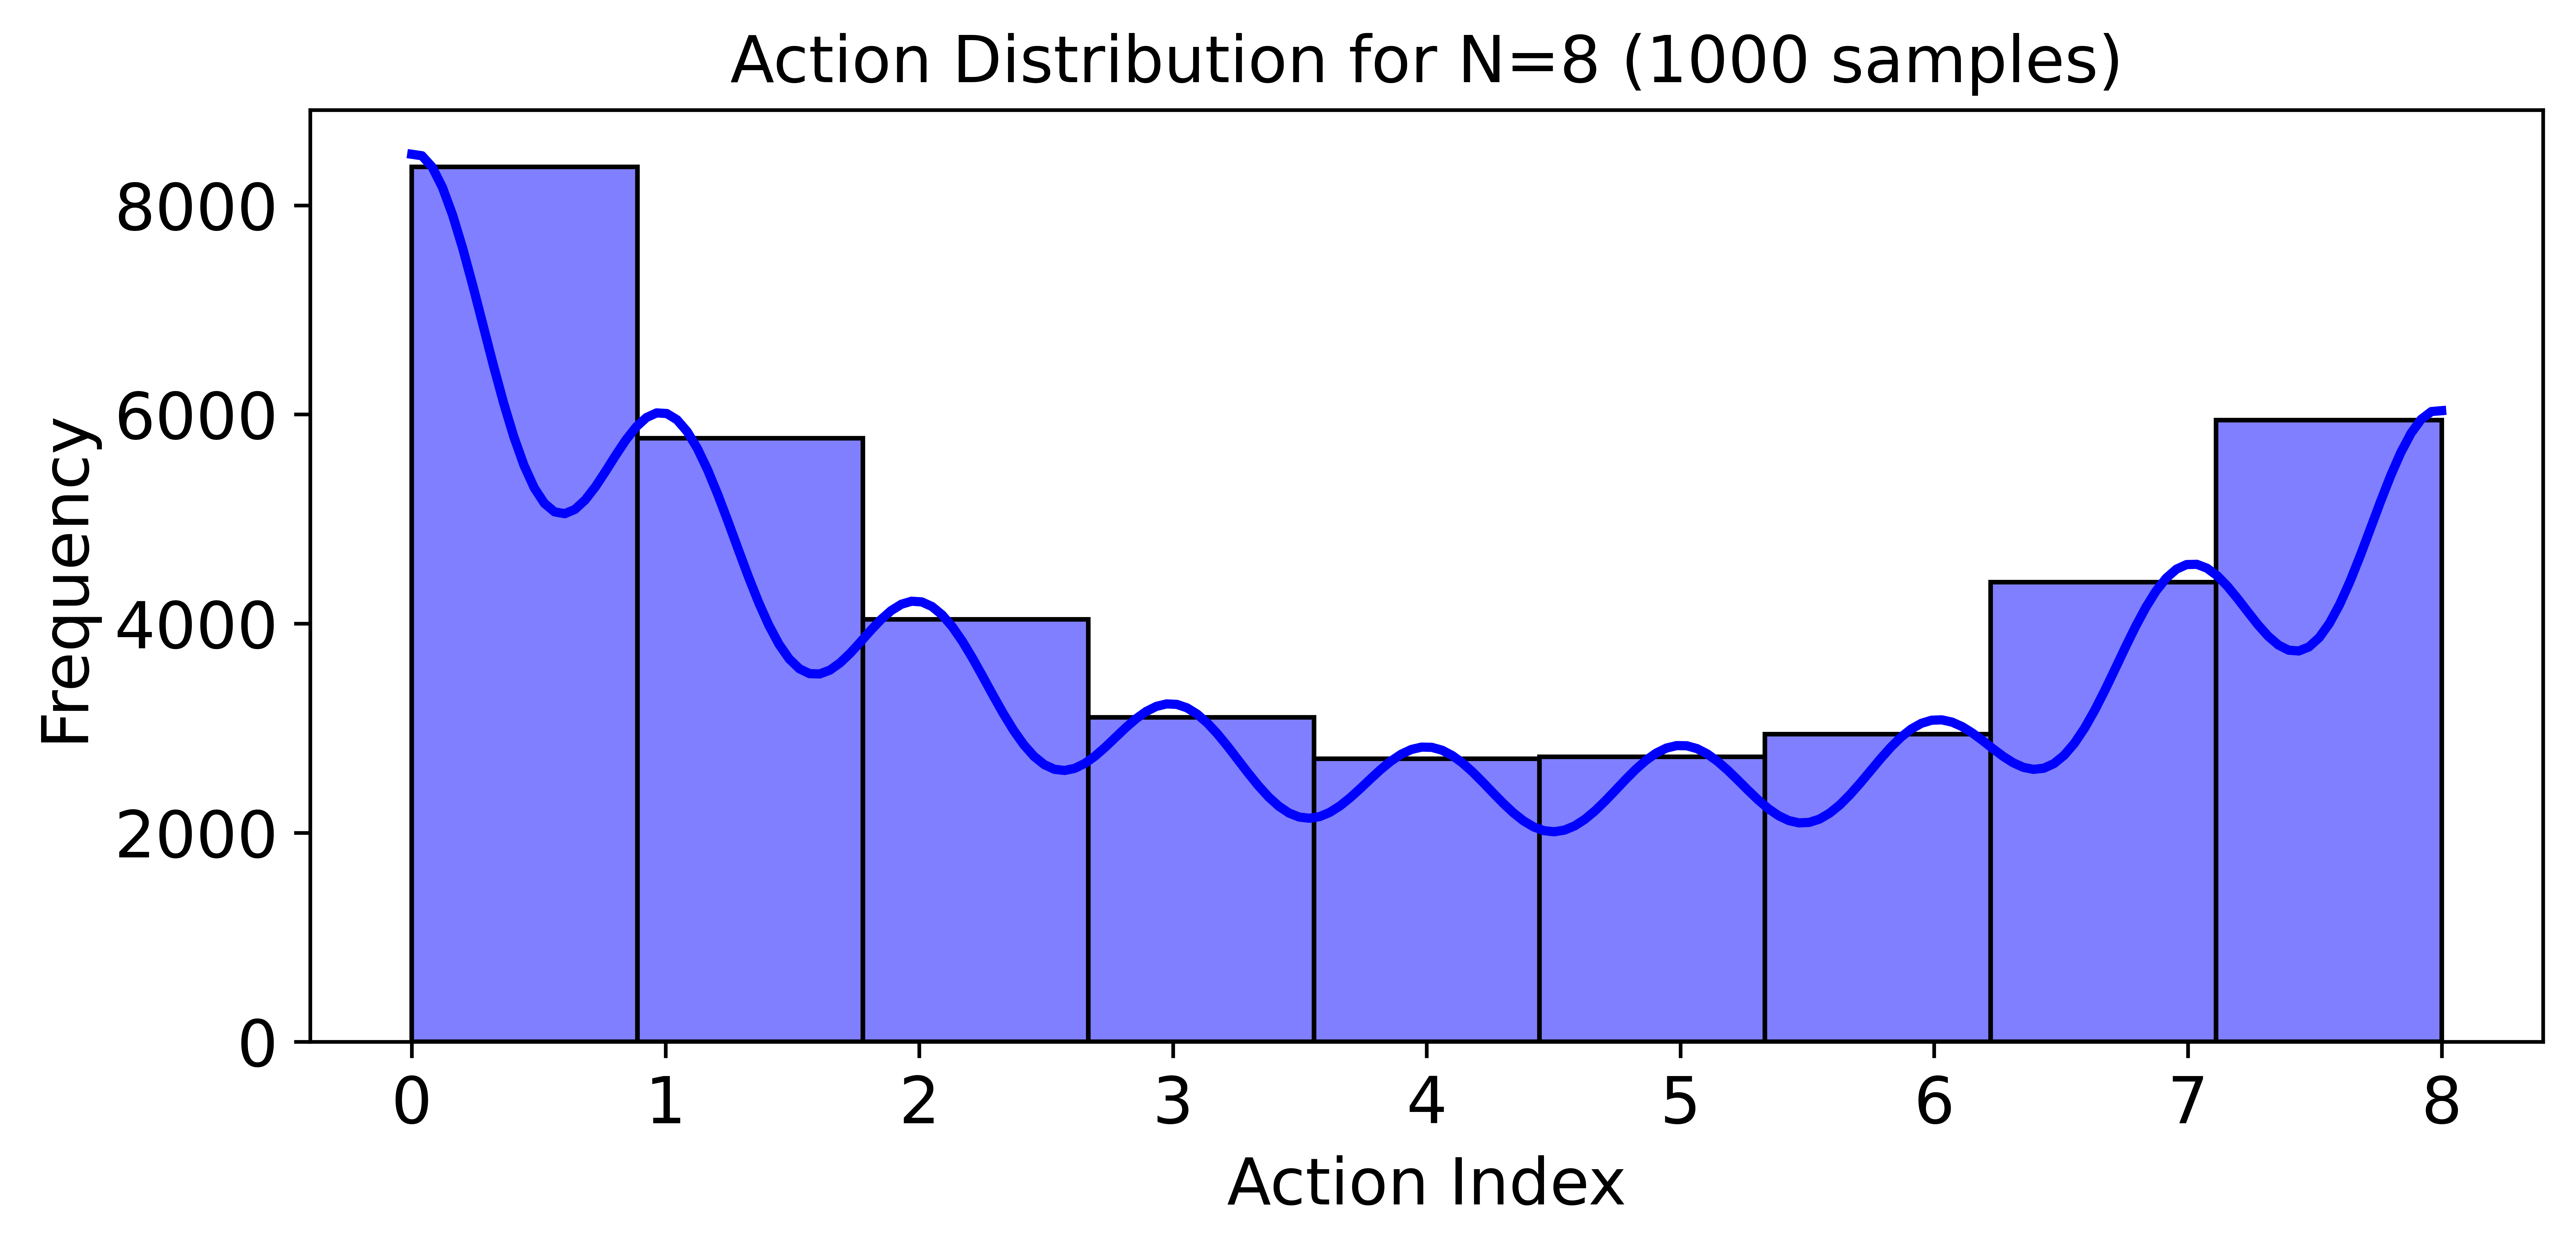
Frecuencia de uso de cada sitio (0 = sin acción).
N=16
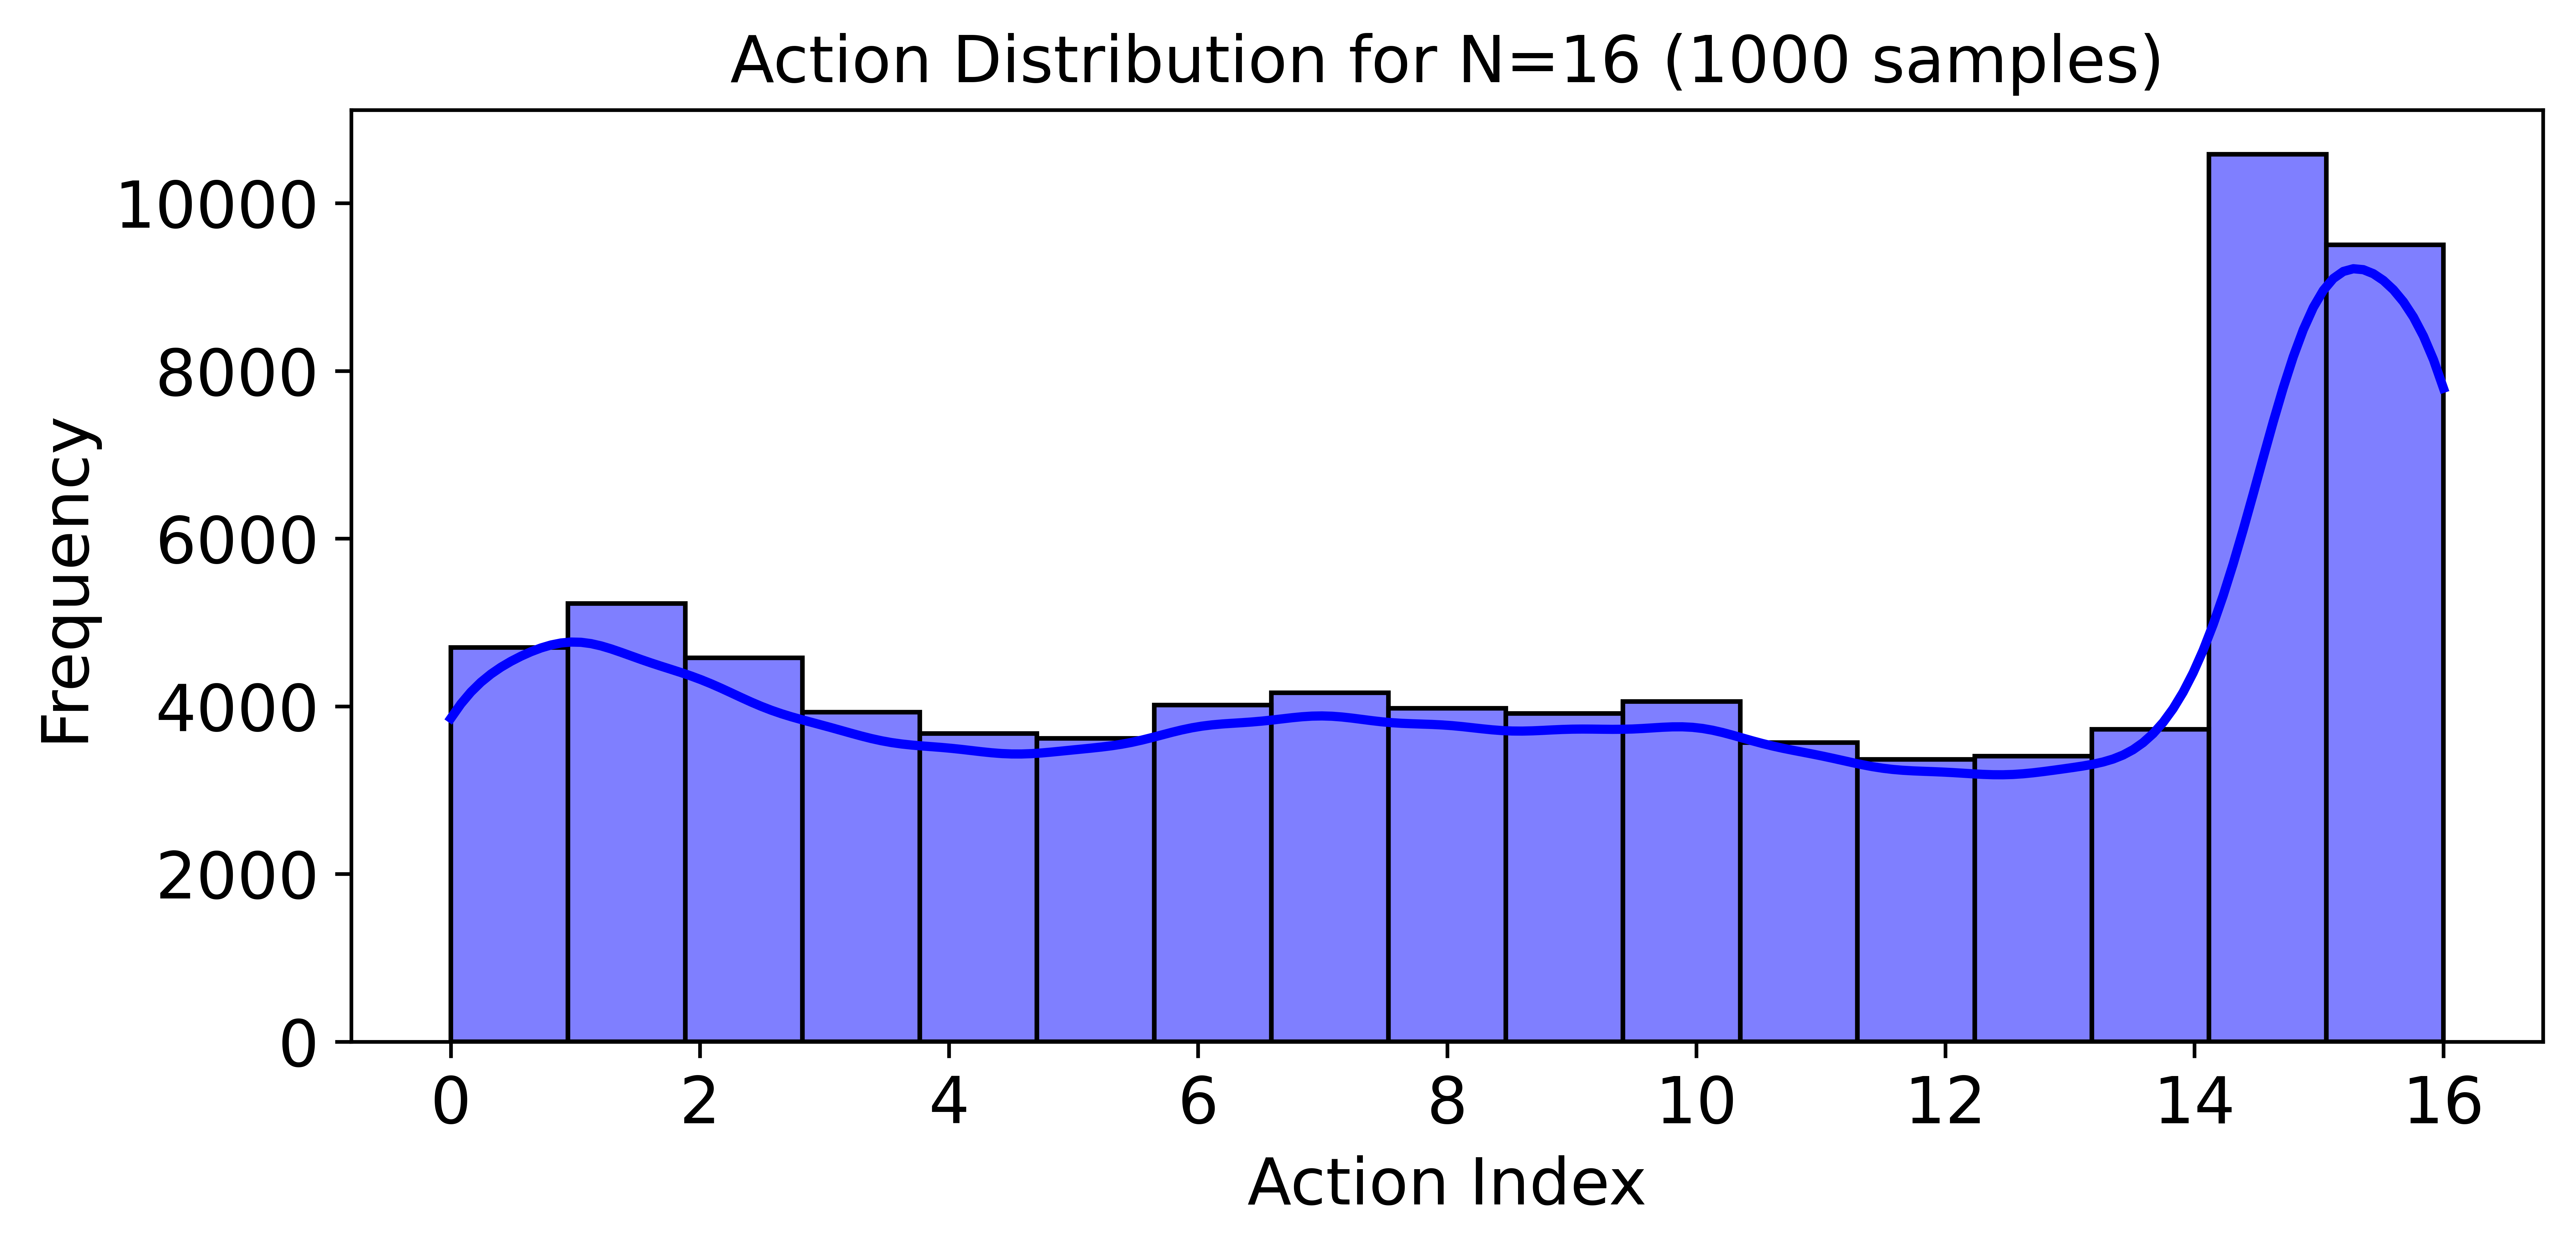
Frecuencia de uso de cada sitio (0 = sin acción).
N=32
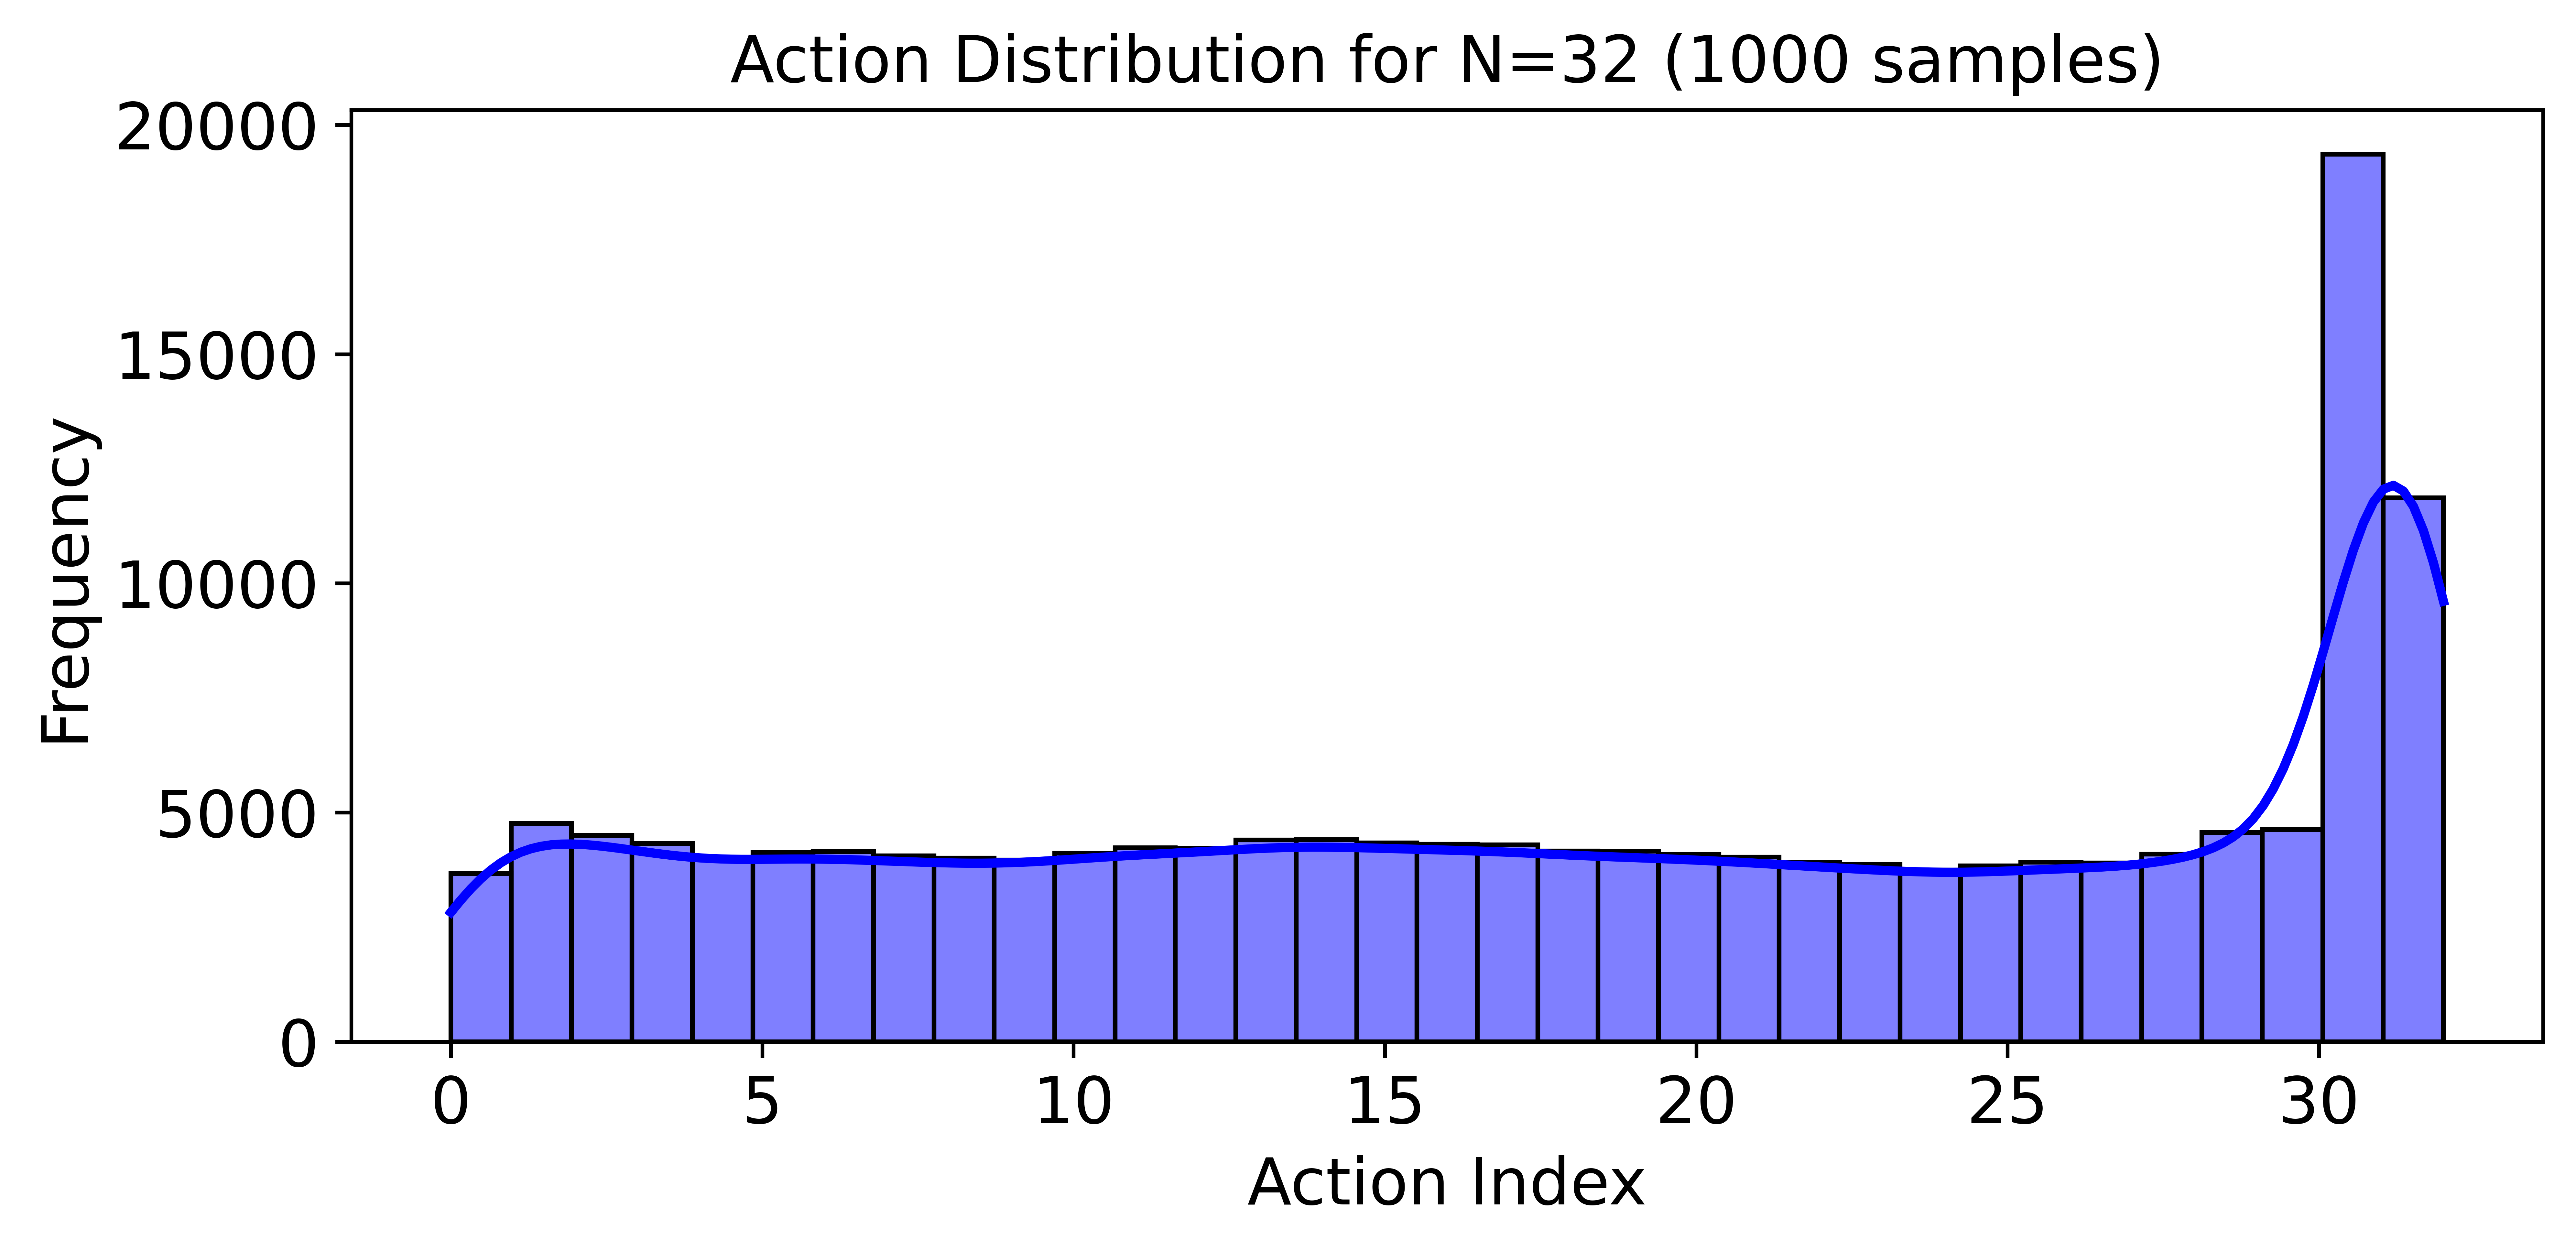
Frecuencia de uso de cada sitio (0 = sin acción).
- La acción "cero" (no actuar) se vuelve menos relevante a medida que crece la longitud de la cadena: para lograr una transferencia exitosa hace falta accionar compuertas de fase no triviales la mayor parte del tiempo
- Los sitios centrales de la cadena se usan más que el resto, excepto por los extremos; el sitio penúltimo destaca con una frecuencia notablemente mayor a la de los demás, consistente con el "congelamiento" de la excitación en el último sitio que se observa en las curvas P(t)
GA para Cadenas Largas
Probabilidad de transmisión vs longitud de cadena, hasta N=128. Los cuadrados son el mejor valor sobre M poblaciones iniciales (alcanza el objetivo de 0.99 hasta N≤60); los círculos son el promedio de los máximos, que decae más rápido. Aun así, el GA mantiene probabilidades máximas mayores a 0.97 en cadenas de 128 qubits.
La dificultad de la tarea crece con la longitud de la cadena: manteniendo fijo el tamaño de la población inicial, el criterio de saturación termina deteniendo el algoritmo antes de alcanzar el objetivo para N>60. Mejorar estos resultados para cadenas muy largas requeriría, sencillamente, más individuos y más poblaciones iniciales.
Conclusiones
- Es sorprendente lo bien que el GA entrega secuencias de control capaces de llevar la transmisión a valores muy altos sobre un rango amplio de longitudes de cadena. Aunque cadenas de cientos de qubits todavía son poco realistas, los resultados muestran que sistemas cuánticos con dimensión de Hilbert de uno o dos cientos son controlables mediante secuencias generadas por GA.
- A pesar de explorar varias funciones de recompensa y conjuntos de acciones, el DQN no alcanza la calidad de transmisión del GA, ni siquiera en cadenas cortas, y la diferencia empeora con la longitud. Una posible explicación es que la fitness del GA evalúa el efecto de la secuencia a lo largo de toda la evolución temporal, mientras que el DQN recompensa acciones locales —una estrategia que funciona en muchos otros problemas de DRL, pero que aquí no alcanza para igualar al GA. No se encontró un patrón reconocible en las acciones usadas por ambos métodos que sugiera una forma práctica de sesgar la búsqueda hacia mejores políticas.
- El trabajo deja una línea abierta para el GA: introducir criterios de fitness "suavizados" que limiten la variabilidad de las secuencias tipo escalón (todavía sin una propuesta convincente). Para el DQN, mejorar su calidad en este régimen ideal requeriría una exploración más efectiva del espacio de acciones junto con una política multi-paso cuya recompensa contemple que la probabilidad de transmisión permanece despreciable durante la mayor parte de la evolución, en línea con el límite cuántico de velocidad. ¿Y qué pasa cuando el control deja de ser ideal? Esa pregunta —y por qué cambia por completo el panorama entre GA y DQN— se desarrolla en el trabajo complementario sobre robustez frente a ruido dinámico.
Charla
Charla sobre este trabajo, "Aprendizaje automático aplicado a la transmisión de estados cuánticos":
Tecnologías
Estado del Trabajo
Este trabajo fue desarrollado como parte de mi investigación doctoral en el Instituto de Física Enrique Gaviola (CONICET-UNC) y la FaMAF-UNC. El artículo fue publicado el 26 de junio de 2026 en Physica Scripta (vol. 101, 265101) y representa una contribución original al campo del control cuántico mediante técnicas de optimización computacional. El estudio de robustez frente a ruido dinámico se desarrolló en colaboración y continúa en una página aparte.
Referencias
[1] X.-M. Zhang et al., Physical Review A 97, 052333 (2018). DOI: 10.1103/PhysRevA.97.052333
[2] S. Perón Santana, A. Fiuri, M. Domínguez y O. Osenda, "The pros and cons of using deep reinforcement learning or genetic algorithms to design control schemes for quantum state transfer on qubit chains", Physica Scripta 101, 265101 (2026). DOI: 10.1088/1402-4896/ae7cc1